
扩展您的机器学习设置:Qdrant中多租户和自定义分片的力量
我们每天都在我们的Discord支持频道上看到关于多租户和分布式部署的话题出现。这告诉我们,你们中的许多人希望与其他机器学习设置一起扩展Qdrant。
无论您是构建银行欺诈检测系统、RAG用于电子商务,还是为联邦政府提供服务 - 您都需要利用多租户架构来扩展您的产品。在SaaS和企业应用程序的世界中,这种设置是常态。它将大幅提高您的应用程序性能并降低您的托管成本。
多租户和Qdrant的自定义分片
我们为此开发了两个主要功能。您现在可以扩展单个Qdrant集群,支持您全球所有客户。 在多租户环境下,每个客户的数据都是完全隔离的,只有他们自己可以访问。当这些数据对位置敏感时,Qdrant还提供了按地区或其他标准划分集群的选项,进一步确保客户的访问安全。这被称为自定义分片。
将这两者结合将产生一个高效分区的架构,进一步利用单个 Qdrant 集群的便利性。本文将简要说明其好处,并展示如何开始使用这两个功能。
一个集合,多个租户
在使用Qdrant时,您可以将所有数据插入到一个集合中,然后通过其有效负载对每个向量进行分区。这意味着所有用户都在利用单个Qdrant集群的强大功能,但他们的数据在集合中仍然是隔离的。让我们来看一下一个双租户集合:
图1: 每个单独的向量被分配一个特定的有效载荷,用于表示它属于哪个租户。这就是大量不同租户可以共享单个Qdrant集合的方式。
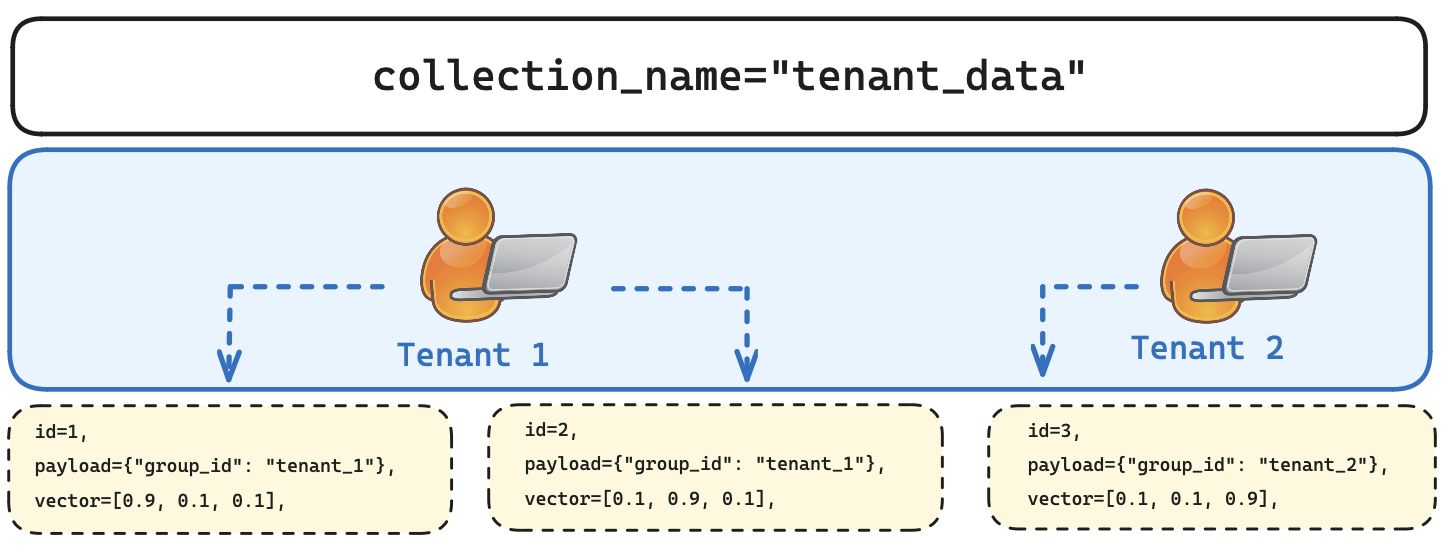
Qdrant旨在在具有大量租户的单个集合中表现出色。只有当您的数据不均质或用户的向量是由不同的嵌入模型创建时,您才应该创建多个集合。创建过多的集合可能会导致资源开销并造成依赖关系。这可能会增加成本并影响整体性能。
分片你的数据库
使用Qdrant,您还可以为每个向量单独指定一个分片。这个功能在您想要 控制数据在集群中的存放位置时非常有用。例如,一组向量可以分配到其自己节点上的一个分片,而另一组可以在完全不同的节点上。
在向量搜索过程中,您的操作将只能命中它们实际需要的子集碎片。在大规模部署中,这可以显著提高不需要扫描整个集合的操作的性能。
这在另一个方向上也有效。每当你搜索某个东西时,你可以指定一个或多个分片,Qdrant 将知道在哪里找到它们。它将避免向你集群中的所有机器请求结果。这将最小化开销并最大化性能。
常见用例
这个功能的一个明确用例是管理一个多租户集合,其中每个租户(无论是用户还是组织)被假设为隔离的,因此他们可以将自己的数据存储在单独的分片中。分片解决了基于区域的数据放置问题,某些数据需要保持在特定的位置。然而,要做到这一点,您需要在节点之间移动您的分片。
图 2: 用户可以在同一个集合中既执行插入更新操作,也可以查询与他们相关的分片。区域分片可以帮助避免跨洲际流量。

自定义分片还可以让您对其他用例进行精确控制。基于时间的数据放置意味着数据流可以索引代表最新更新的分片。如果您按日期组织分片,则可以对检索到的数据的最新性有很好的控制。这对于社交媒体平台是相关的,因为这些平台在很大程度上依赖于时间敏感的数据。
在我进一步之前…..我的用户数据有多安全?
从设计上讲,Qdrant 提供三种隔离级别。我们最初引入了基于集合的隔离,但您的扩展设置必须超越这一水平。在这种情况下,您将利用基于有效负载的隔离(来自多租户)和基于资源的隔离(来自分片)。最终目标是拥有一个单一的集合,您可以在其中更精确地操作和自定义集群内部的分片放置,并避免任何类型的开销。下面的图表显示了您数据在双层隔离结构中的排列。
图3: 用户可以根据两个过滤器查询集合:group_id 和单个shard_key_selector。这为您的数据提供了额外的两个隔离级别。

为单个集合创建自定义分片
创建集合时,您需要配置用户定义的分片。这使您可以控制数据的分片位置,以便操作仅能访问它们实际需要的分片子集。在大型集群中,这可以显著提高操作的性能,因为您不需要遍历整个集合来检索数据。
client.create_collection(
    collection_name="{tenant_data}",
    shard_number=2,
    sharding_method=models.ShardingMethod.CUSTOM,
    # ... other collection parameters
)
client.create_shard_key("{tenant_data}", "canada")
client.create_shard_key("{tenant_data}", "germany")
在这个例子中,您的集群分布在德国和加拿大。加拿大和德国的法律在国际数据转移方面存在差异。假设您正在创建一个支持医疗保健行业的RAG应用程序。出于合规目的,您的加拿大客户数据必须与您的德国客户数据清楚地分开。
虽然它是同一集合的一部分,但每个分片的数据与其他分片是隔离的,可以单独检索。有关分片和检索的更多示例,请参考 分布式部署 文档和 Qdrant 客户端规范。
为用户配置多租户设置
让我们继续并开始添加数据。当你将向量插入到新的集合中时,可以为每个向量添加一个 group_id 字段。如果这样做,Qdrant 将把每个向量分配到相应的组。
此外,每个向量现在可以分配给一个分片。您可以为每个单独的向量指定 shard_key_selector。在这个例子中,您正在将属于 tenant_1 的数据插入到加拿大地区。
client.upsert(
    collection_name="{tenant_data}",
    points=[
        models.PointStruct(
            id=1,
            payload={"group_id": "tenant_1"},
            vector=[0.9, 0.1, 0.1],
        ),
        models.PointStruct(
            id=2,
            payload={"group_id": "tenant_1"},
            vector=[0.1, 0.9, 0.1],
        ),
    ],
    shard_key_selector="canada",
)
请记住,每个 group_id 的数据是独立的。以下示例中,tenant_1 的向量与 tenant_2 的向量分开。第一个租户将能够访问他们在集群的加拿大部分的数据。然而,如下所示,tenant_2 可能只能检索位于德国的信息。
client.upsert(
    collection_name="{tenant_data}",
    points=[
        models.PointStruct(
            id=3,
            payload={"group_id": "tenant_2"},
            vector=[0.1, 0.1, 0.9],
        ),
    ],
    shard_key_selector="germany",
)
通过过滤器检索数据
访问控制设置已完成,因为您指定了数据检索的标准。在搜索向量时,您需要使用 query_filter 和 group_id 来过滤每个用户的向量。
client.search(
    collection_name="{tenant_data}",
    query_filter=models.Filter(
        must=[
            models.FieldCondition(
                key="group_id",
                match=models.MatchValue(
                    value="tenant_1",
                ),
            ),
        ]
    ),
    query_vector=[0.1, 0.1, 0.9],
    limit=10,
)
性能考虑
如果以这种方式添加大量数据,索引速度可能会成为瓶颈,因为每个用户的向量将被索引到同一个集合中。为了避免这个瓶颈,考虑为整个集合绕过全局向量索引的构建,而只为单个组进行构建。
通过采用这一策略,Qdrant将为每个用户独立索引向量,显著加快这一过程。
要实施这种方法,您应该:
- 在HNSW配置中将
payload_m设置为非零值,例如16。 - 将
m在 hnsw 配置中设置为 0。这将禁用为整个集合构建全局索引。
from qdrant_client import QdrantClient, models

client = QdrantClient("localhost", port=6333)

client.create_collection(
    collection_name="{tenant_data}",
    vectors_config=models.VectorParams(size=768, distance=models.Distance.COSINE),
    hnsw_config=models.HnswConfigDiff(
        payload_m=16,
        m=0,
    ),
)
- 为
group_id字段创建关键词有效载荷索引。
client.create_payload_index(
    collection_name="{tenant_data}",
    field_name="group_id",
    field_schema=models.PayloadSchemaType.KEYWORD,
)
注意:请记住,全球请求(没有
group_id过滤)将会更慢,因为它们需要扫描所有组以识别最近的邻居。
探索Qdrant中的多租户和自定义分片以实现可扩展解决方案
Qdrant 准备好支持您机器学习项目的大规模架构。如果您想看看我们的 向量数据库 是否适合您,请尝试 快速入门教程 或阅读我们的 文档和教程。
要启动一个免费的Qdrant实例,请注册Qdrant Cloud - 没有任何附加条件。
在我们的 Discord 社区获取支持或分享想法。这是我们讨论向量搜索理论、发布示例和演示以及讨论向量数据库设置的地方。